Hoy en el blog no hablamos de formación. Os presentamos Engrama, una memoria persistente para agentes de inteligencia artificial que hemos desarrollado en Sinensia, que usamos a diario y que ahora abrimos por invitación.
Cada conversación empieza en blanco
Los modelos de IA son cada vez más capaces, pero no recuerdan lo que hicimos ayer con ellos. En cada sesión hay que volver a explicar el proyecto, las decisiones tomadas, lo que se descartó y por qué.
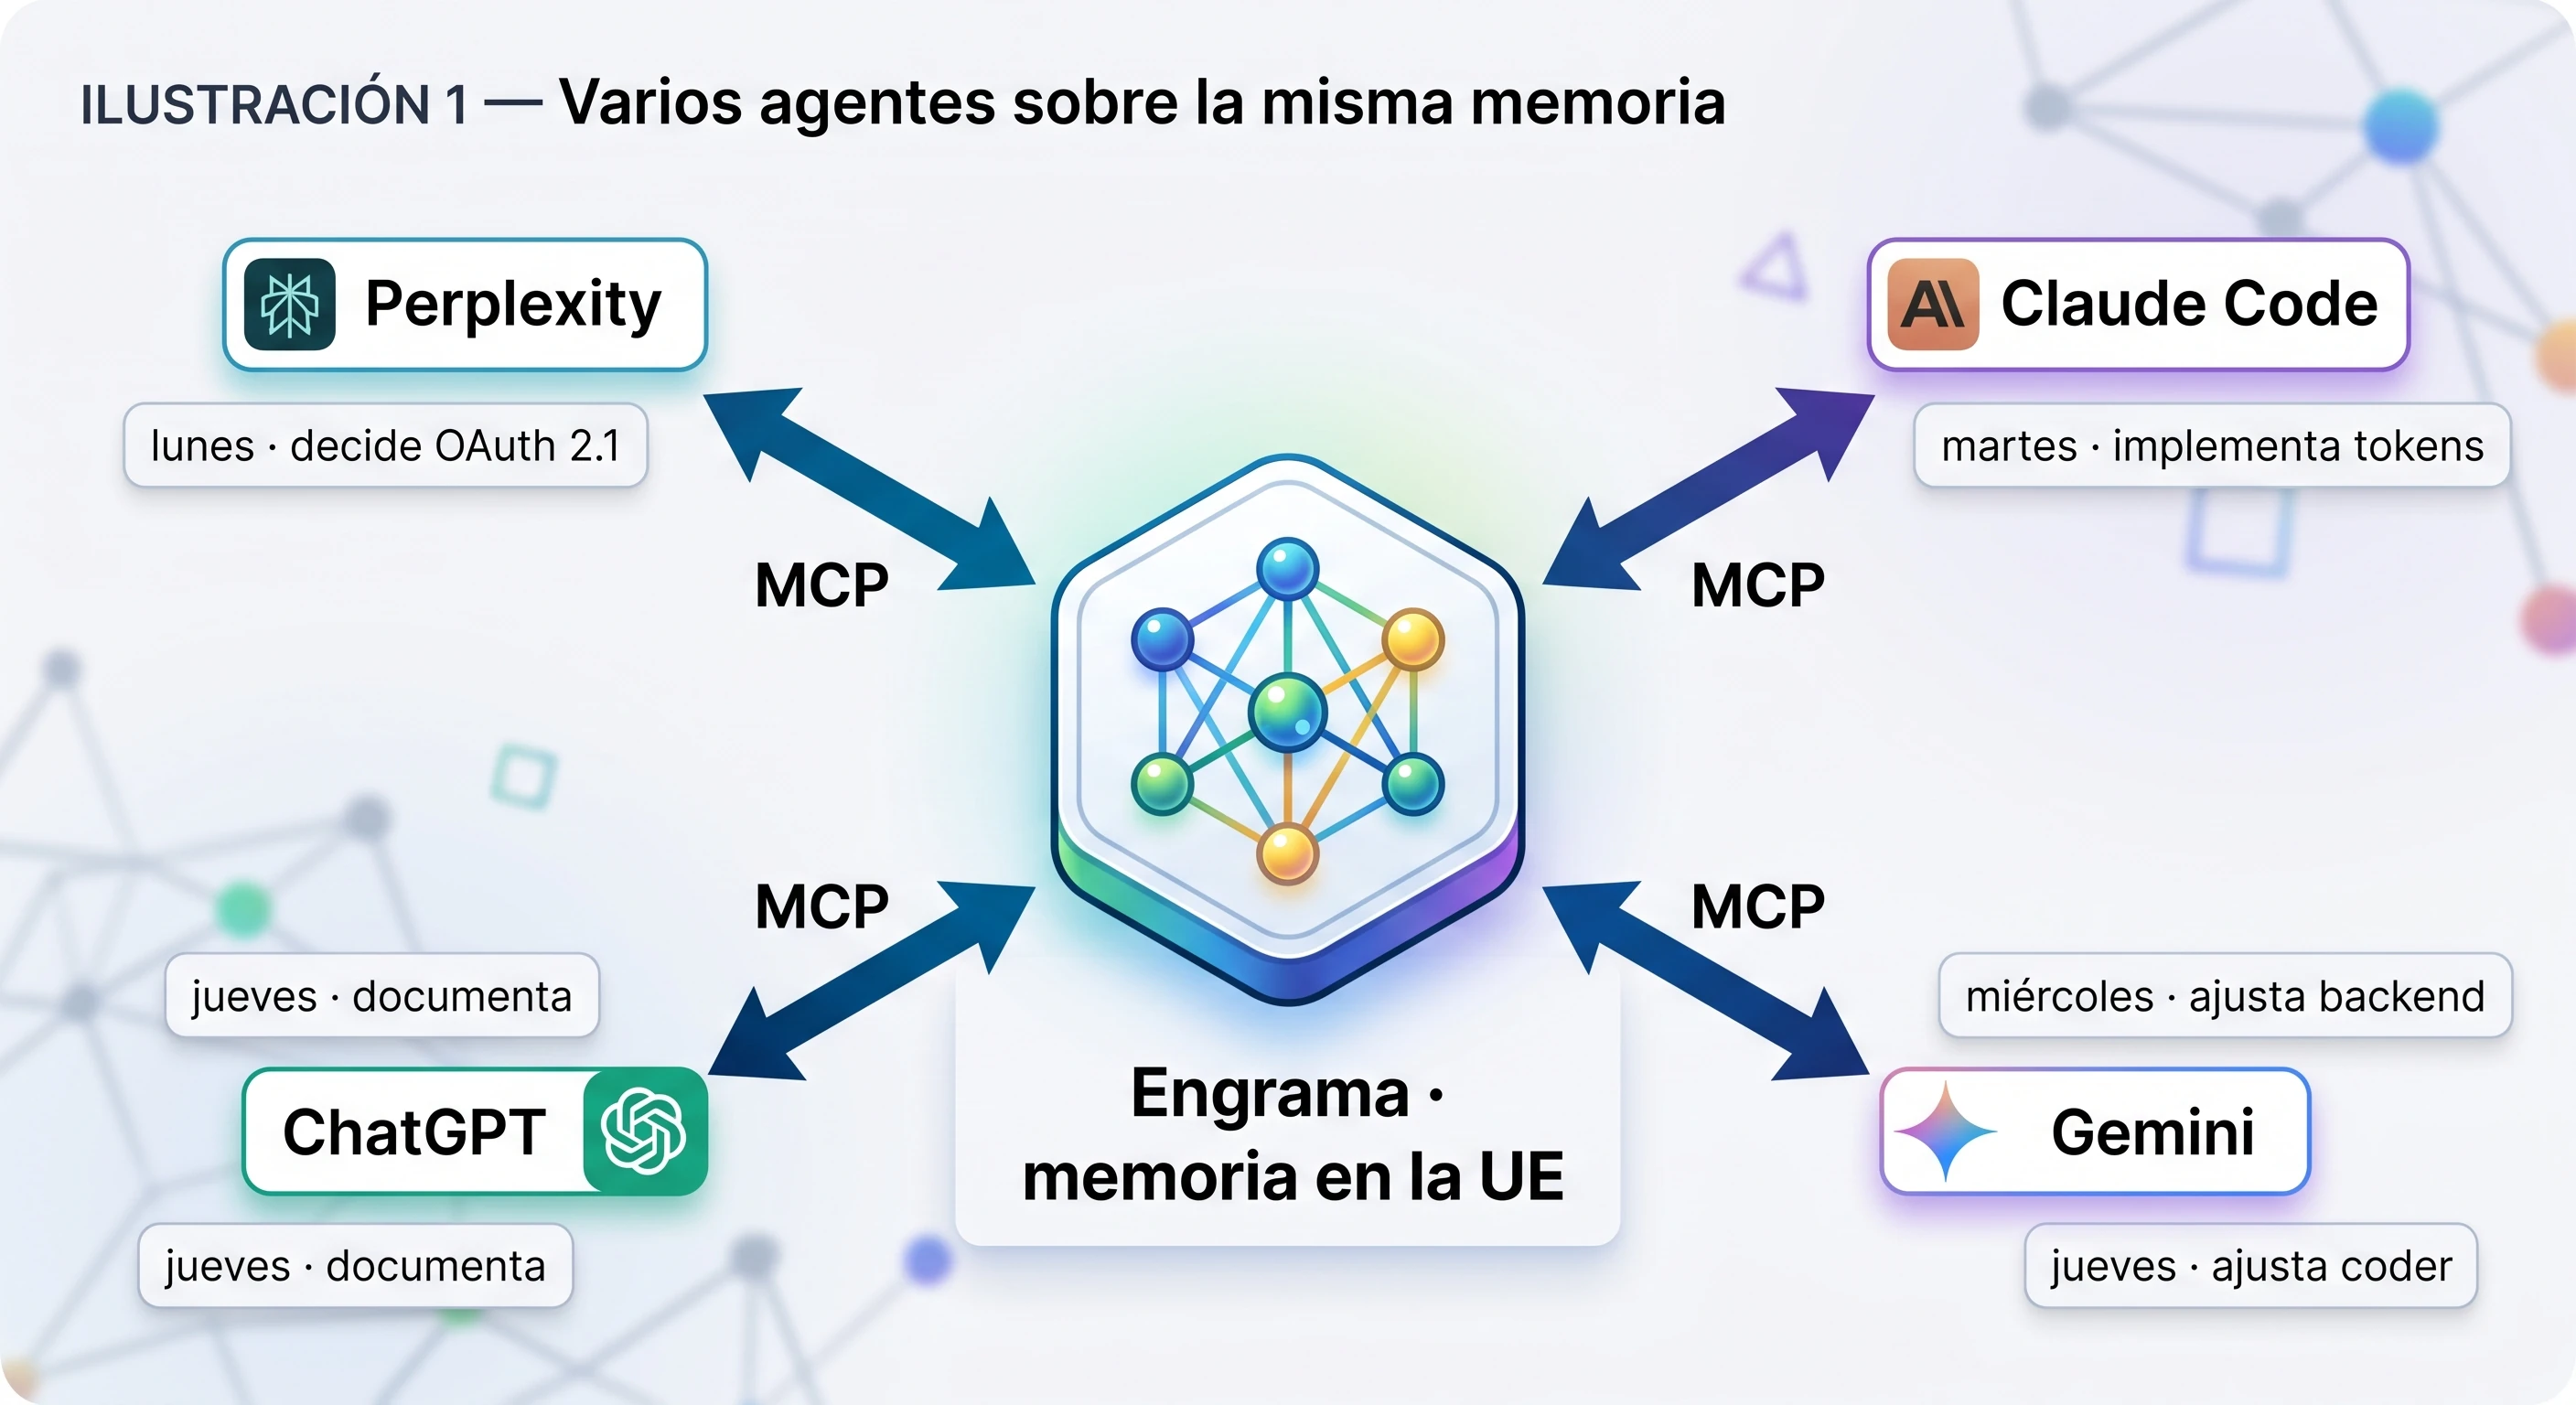
Con varias herramientas es peor. Es normal investigar con Perplexity, programar con Claude Code, redactar con ChatGPT y revisar con Gemini, y cada una guarda su propio contexto (cuando lo guarda) sin saber nada de lo que pasó en las otras. Al final alguien acaba copiando y pegando resúmenes de una a otra.
Qué es Engrama
Engrama es una memoria externa a la que los agentes se conectan mediante MCP (Model Context Protocol), el estándar abierto que permite a los asistentes de IA usar herramientas externas. Se conecta el cliente, se autentica una vez y, desde ese momento, el agente guarda lo que importa y lo recupera cuando lo necesita.
La información vive en Engrama y no en el agente. Por eso da igual con qué modelo se trabaje: Claude, ChatGPT, Perplexity, Gemini y cualquier cliente compatible con MCP leen y escriben en la misma memoria, y lo que se resolvió ayer con uno lo sabe hoy el otro.
Caso 1: memoria compartida entre agentes
Pongamos un equipo que desarrolla una API.
El lunes investiga con Perplexity cómo autenticarla y decide usar OAuth 2.1 con un proveedor de identidad europeo. Engrama guarda la decisión, las alternativas descartadas y el motivo.
El martes, en Claude Code, el agente implementa la autenticación. Antes de empezar consulta Engrama, encuentra la decisión del lunes y la aplica. Por el camino aparece un problema con la caducidad de los tokens; el equipo lo resuelve y la solución queda registrada, conectada al proyecto y a la decisión original.
El jueves, el equipo pide a ChatGPT la documentación técnica del módulo. El modelo ya conoce la arquitectura, el problema de los tokens y cómo se resolvió, sin que nadie le haya pegado un resumen.
Caso 2: el grafo enriquece la respuesta
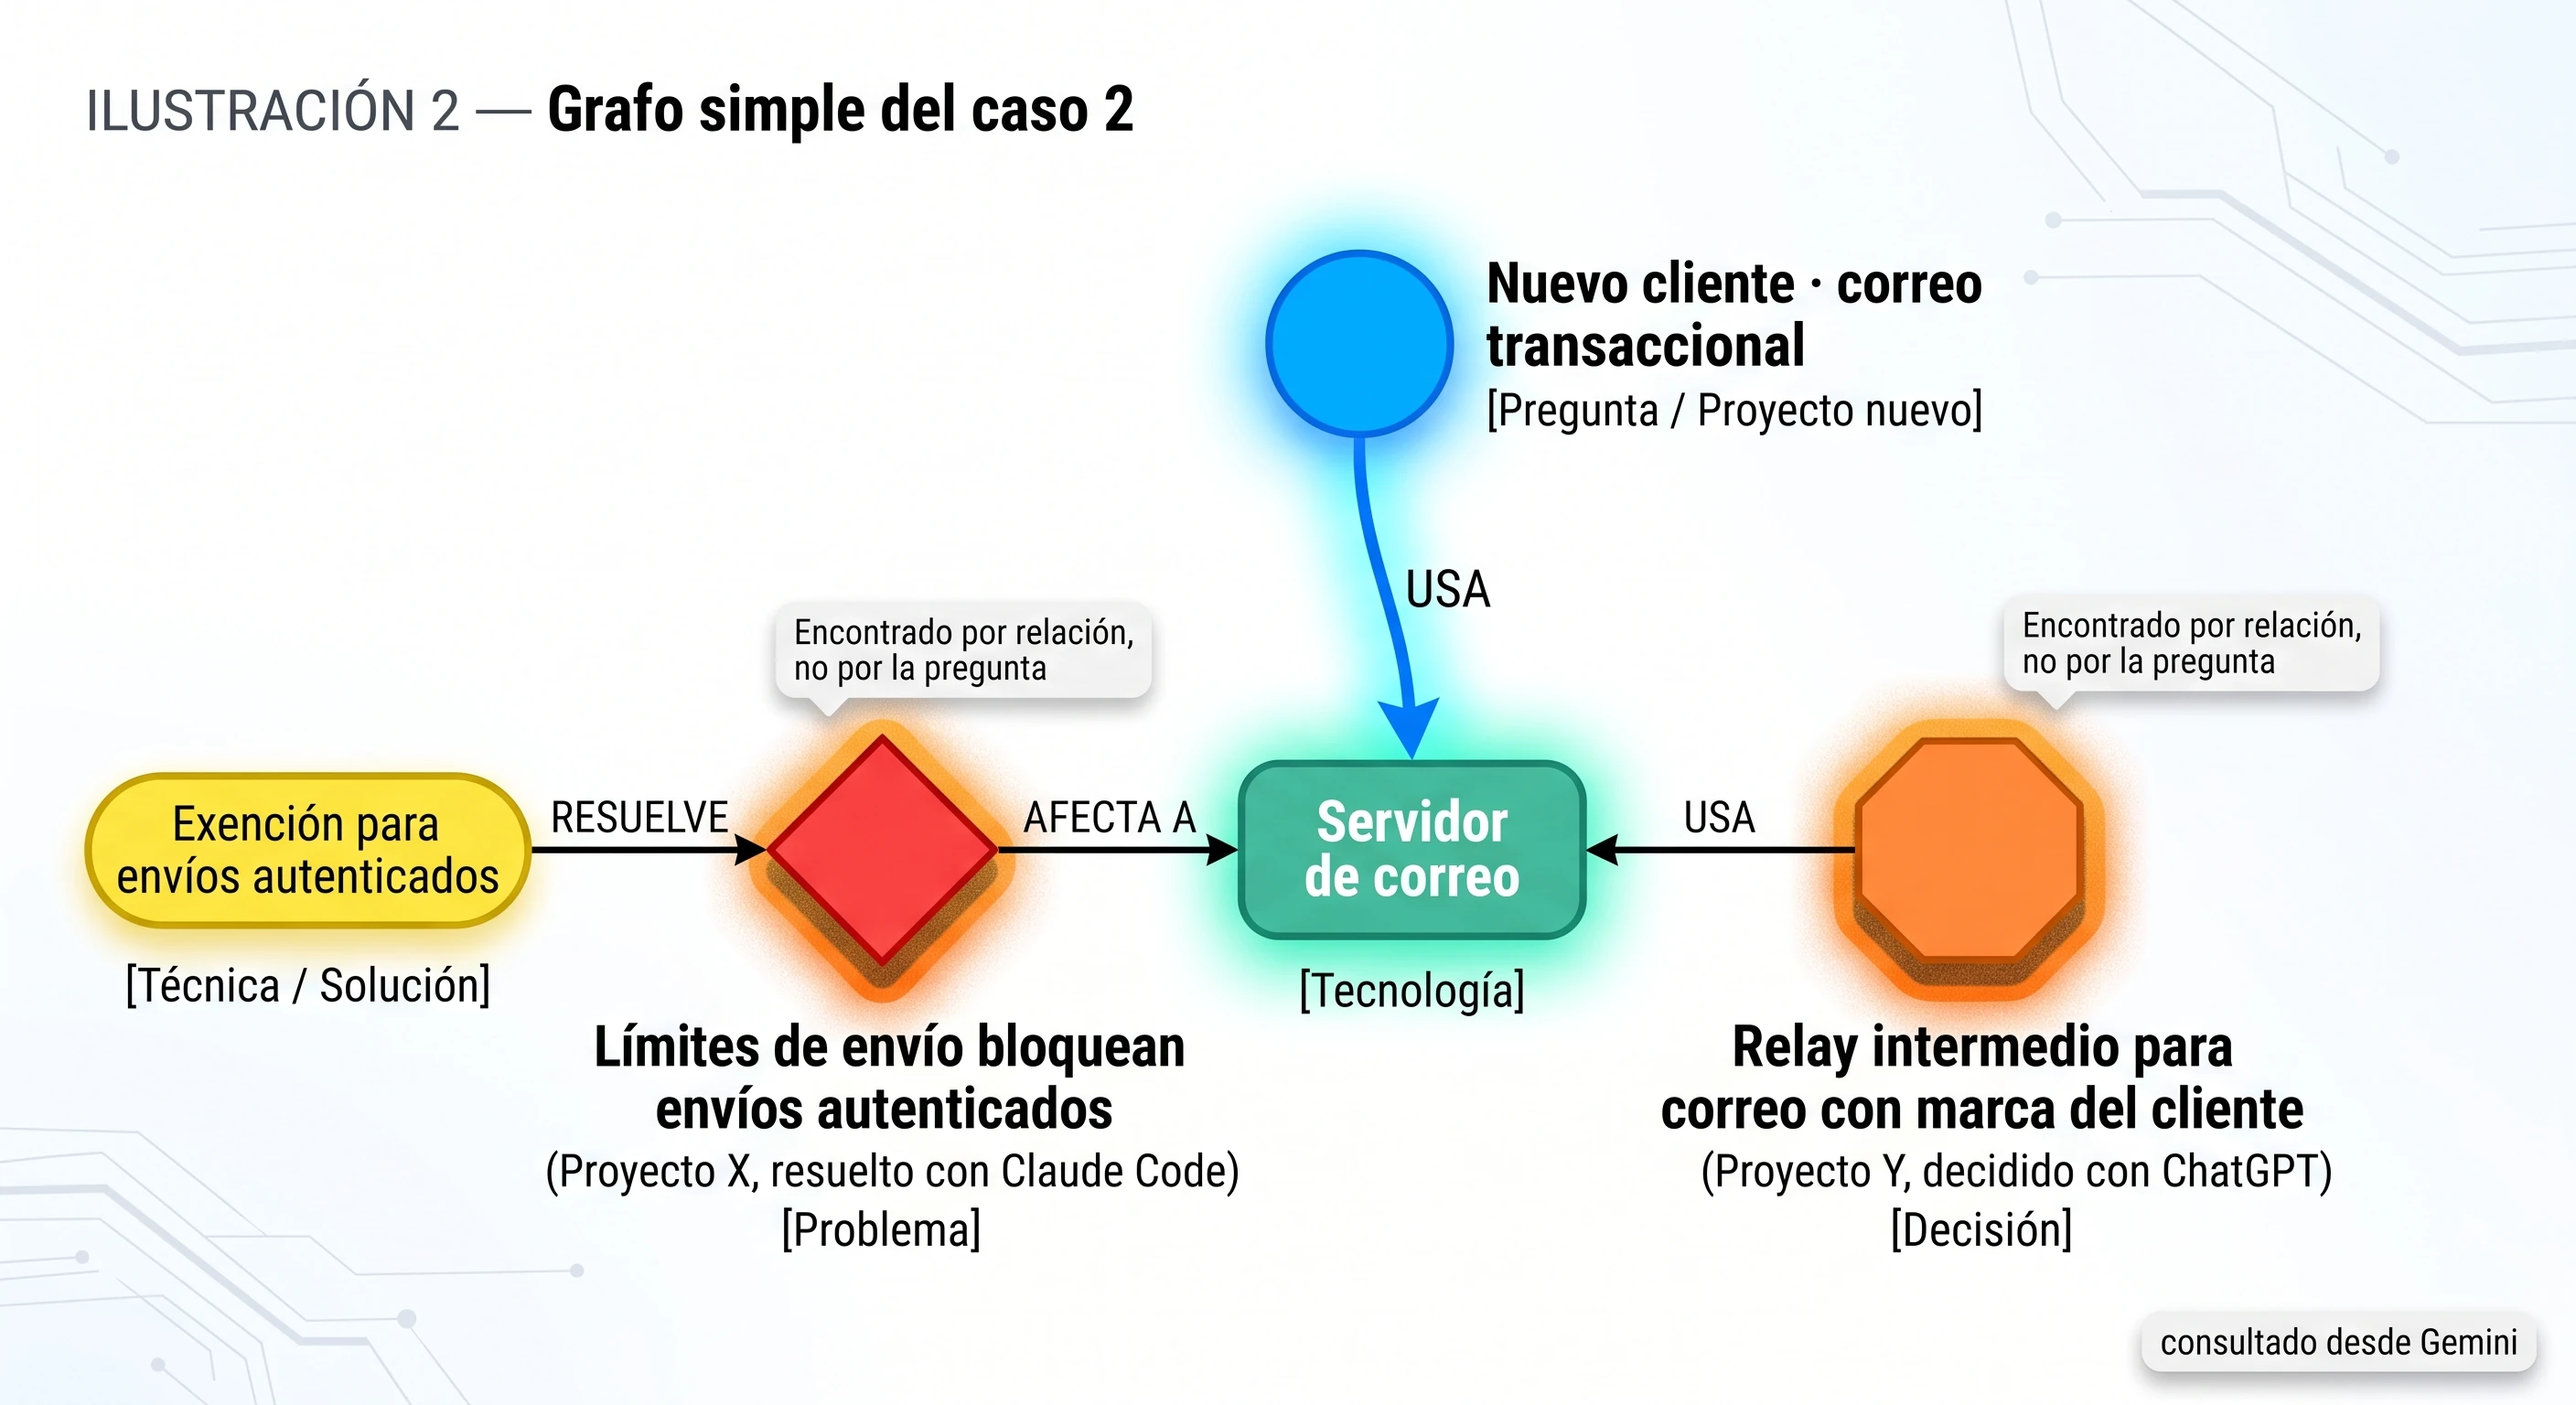
Engrama organiza la información como un grafo de conocimiento: nodos (proyectos, decisiones, problemas, tecnologías, técnicas) unidos por relaciones con significado, como usa, resuelve, depende de o se decidió por. Gracias a eso, el agente puede responder a lo que se pregunta y traer también lo que está conectado con ello.
Se pregunta:
¿Cómo configuro el correo transaccional para el nuevo cliente?
El modelo da los pasos de configuración. Pero al consultar Engrama ve que el servidor de correo elegido está conectado con otros dos nodos del grafo. Uno es un problema resuelto hace tres meses en otro proyecto: los límites de envío de ese servidor bloqueaban también los mensajes autenticados de la propia aplicación, y hubo que configurar una exención. El otro es una decisión de arquitectura de otro cliente, que para enviar correo con su propia marca optó por un relay intermedio en lugar del envío directo.
La respuesta llega así:
Estos son los pasos. En el proyecto X este mismo servidor bloqueó los envíos autenticados por los límites de envío, así que conviene configurar la exención desde el principio. Si este cliente también quiere correo con su marca, en el proyecto Y se resolvió con un relay intermedio.
Nadie había preguntado por esos dos proyectos; el agente llegó a ellos siguiendo las relaciones del grafo. El problema de hace tres meses se resolvió con Claude Code, la decisión de arquitectura salió de una conversación con ChatGPT y la pregunta de hoy se hace desde Gemini. Como todo está en Engrama, el agente de hoy aprovecha lo que hicieron los otros.
Caso 3: retomar un proyecto semanas después
Cuando un proyecto se para un mes, lo primero al volver es saber dónde se quedó. El agente recupera el nodo del proyecto y lo que tiene alrededor: las decisiones vigentes, los problemas abiertos, lo pendiente y las tecnologías implicadas. En unos segundos hay una foto del estado real sin releer hilos antiguos ni buscar en varias aplicaciones.
Engrama también propone conexiones
De vez en cuando Engrama revisa la memoria acumulada y busca patrones que nadie le ha pedido. Puede detectar, por ejemplo, que dos proyectos que nunca se habían relacionado usan la misma plataforma, y sugerir que se reutilice en uno el material o la experiencia del otro.
Esas sugerencias necesitan la aprobación del usuario antes de pasar a formar parte de la memoria. Así es una persona quien decide qué se queda.
¿Por qué no basta con un RAG sobre documentos de memoria?
Una solución habitual es escribir documentos de contexto (notas del proyecto, resúmenes, decisiones) e indexarlos en un RAG. El sistema trocea los documentos, busca los fragmentos más parecidos a la pregunta y los añade a la conversación. Funciona, pero con el uso aparecen varios límites.
Un RAG recupera trozos de texto parecidos a la pregunta, sin saber cómo se relacionan entre sí. Si nadie escribió en el mismo párrafo que el servidor de correo tuvo un problema hace tres meses, esa conexión no aparece. En Engrama la relación está guardada de forma explícita, y es lo que permite pasar de la pregunta a los otros dos proyectos del ejemplo.
Los documentos también envejecen mal. En un RAG conviven la decisión antigua y la nueva, y las dos pueden colarse en la respuesta. En Engrama cada cosa es un único nodo que se actualiza, y una decisión sustituida queda marcada como tal.
Luego está el tamaño. Un fragmento de RAG es un bloque de texto de longitud fija, relevante solo en parte. Un nodo de Engrama tiene un resumen breve, y el detalle se pide solo cuando hace falta. Como orden de magnitud orientativo, pegar en cada conversación un documento de proyecto de veinte páginas puede superar los diez mil tokens, mientras que recuperar los cinco nodos relevantes con sus resúmenes se queda en una fracción. El ahorro exacto depende del modelo y de la forma de trabajar.
Enviar menos texto también reduce la exposición. Si al modelo solo le llega el contexto que necesita la tarea, también le llegan menos datos de clientes, configuraciones o decisiones internas.
Además, alguien tiene que escribir y mantener esos documentos al día. En Engrama es el propio agente quien registra decisiones, problemas y soluciones mientras trabaja. Y un RAG suele estar atado a la aplicación que lo usa, mientras que Engrama es una capa común para todos los clientes MCP.
La búsqueda de Engrama combina dos formas de buscar: por significado, que encuentra "vídeos de clase" aunque se guardara como "grabación de sesiones", y por texto exacto, para nombres, dominios o identificadores. Las relaciones del grafo se suman a ambas.
Privada, europea y portable
En Sinensia formamos en seguridad ofensiva, y la privacidad fue un requisito desde el primer día.
La infraestructura, el almacenamiento, las copias de seguridad y la gestión de identidad están en proveedores de la Unión Europea. La identidad de cada usuario se resuelve en el servidor y nunca depende de lo que diga el modelo; si no está clara, la consulta devuelve cero resultados, porque preferimos no mostrar nada a arriesgarnos a mostrar datos de otra persona. El grafo completo se puede descargar en JSON en cualquier momento, y si se solicita el borrado se elimina toda la memoria.
Código abierto
El núcleo de Engrama es software libre con licencia Apache 2.0 y está en github.com/scops/engrama. Quien lo prefiera puede instalarlo en su propia infraestructura. El servicio de engrama.sinensia.com es para quien quiere usarlo sin administrar servidores ni bases de datos.
Para empresas: infraestructura dedicada en la UE
Hay empresas que no pueden compartir infraestructura con nadie, por política interna, por sector o por los datos que manejan. Para ellas tenemos un plan de Engrama sobre infraestructura dedicada, con el mismo enfoque EU-first: la instancia se despliega solo para esa empresa y en la Unión Europea.
Si es vuestro caso, escribidnos desde engrama.sinensia.com y vemos juntos qué necesitáis.
Prueba Engrama durante tres meses
Engrama está en fase de acceso por invitación. Queremos crecer con usuarios que lo usen en proyectos reales y nos cuenten qué les funciona y qué echan en falta.
Por eso ofrecemos una prueba de tres meses. Da tiempo a conectar las herramientas, trabajar con varios modelos sobre la misma memoria y comparar lo que supone empezar cada conversación de cero con retomarla donde se dejó.
Solicita tu invitación en engrama.sinensia.com.